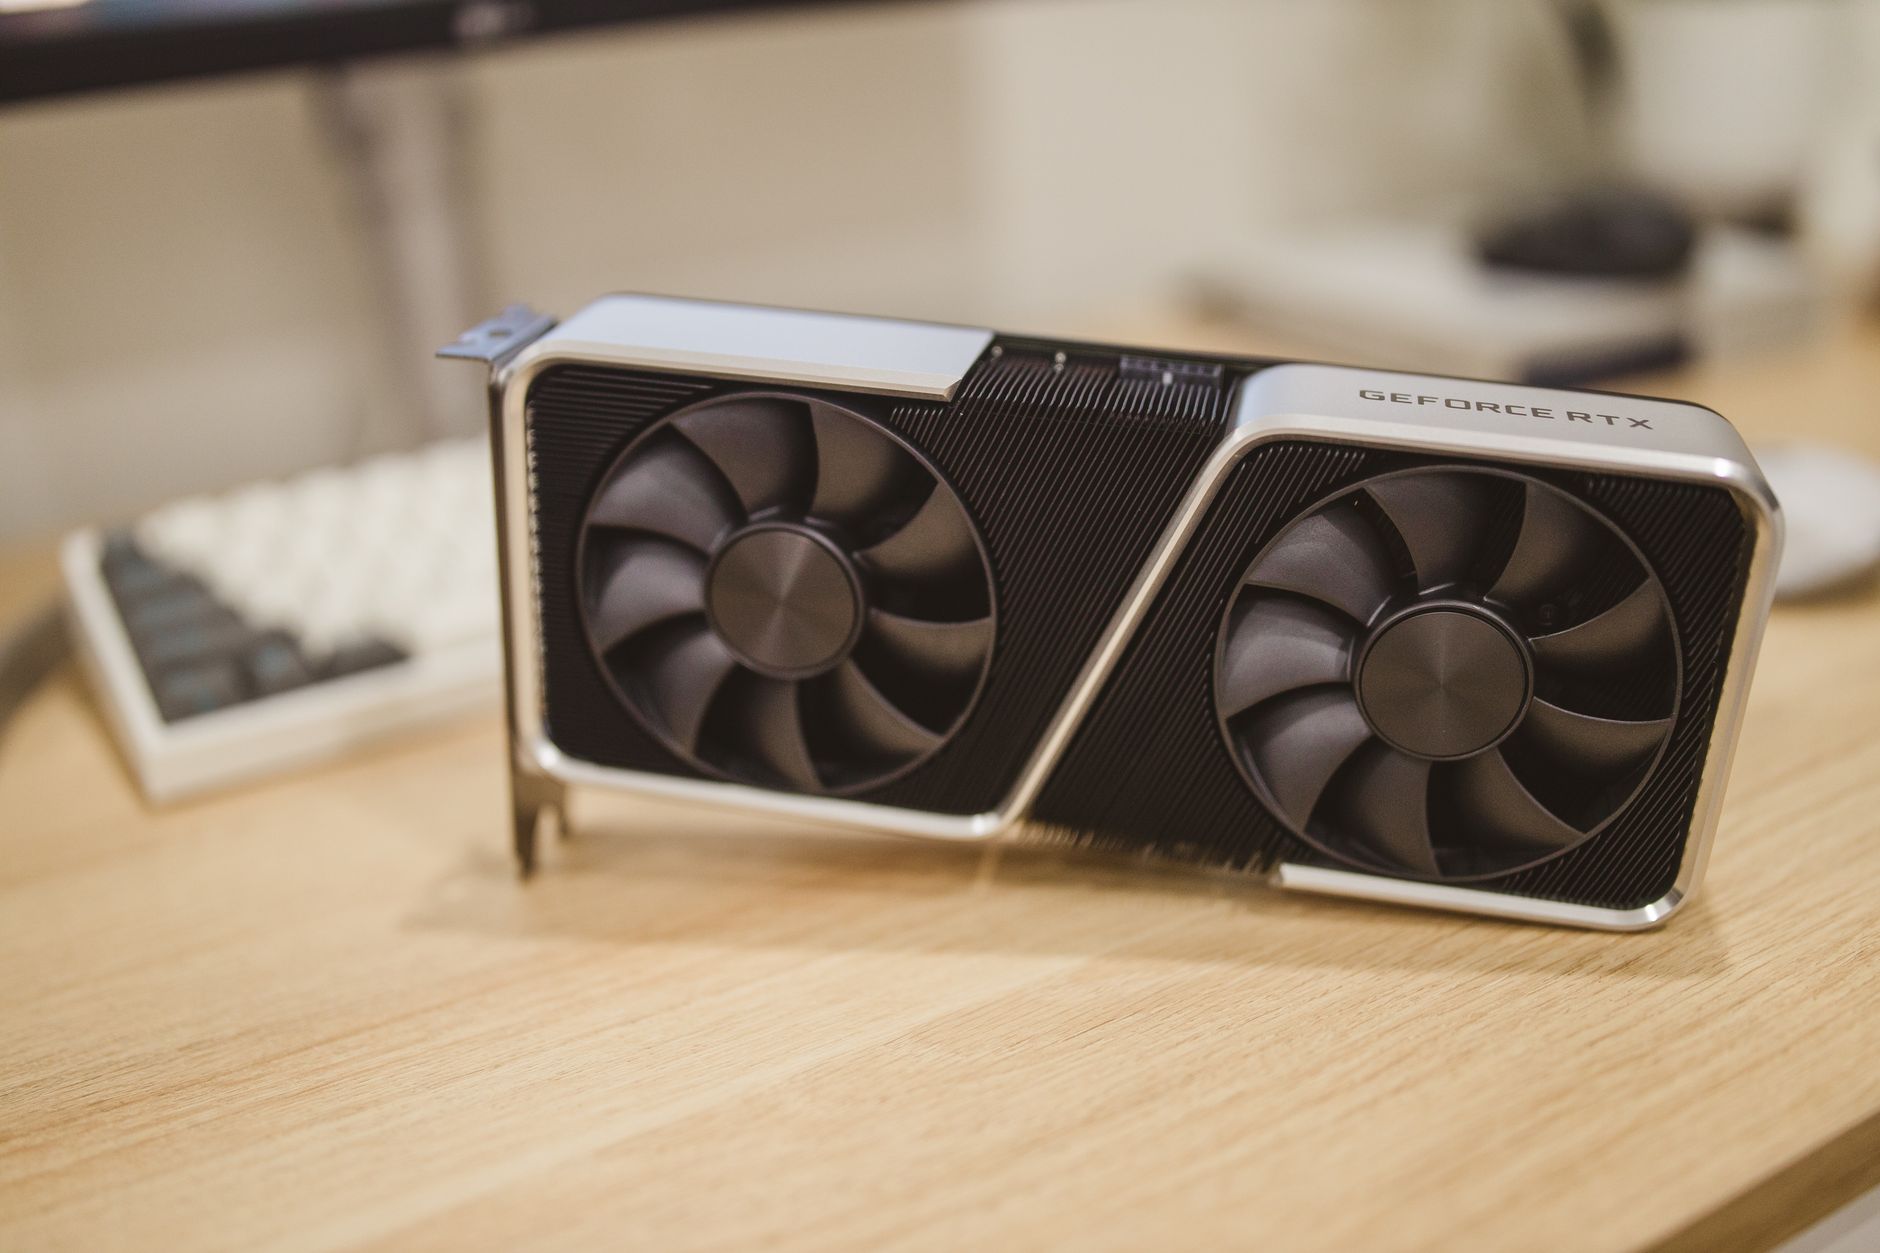
Stoisz przed wyborem komputera do nauki uczenia maszynowego lub zastanawiasz się, czy Twój obecny sprzęt poradzi sobie z pierwszymi projektami? Zanim wydasz kilka tysięcy złotych na topową kartę graficzną, warto zadać sobie jedno kluczowe pytanie: jakie konkretnie zadania i na jakich danych planujesz realizować? Odpowiedź na to pytanie rzadko bywa jednowymiarowa, ponieważ świat uczenia maszynowego jest niezwykle zróżnicowany.
Krótka informacja dla osób szukających natychmiastowej odpowiedzi brzmi: nie, na samym początku nauki machine learningu nie potrzebujesz mocnej karty graficznej. Istnieje cała gałąź tradycyjnego uczenia maszynowego, która działa błyskawicznie na zwykłym procesorze. Sytuacja zmienia się jednak drastycznie, gdy wkraczasz w świat głębokich sieci neuronowych, przetwarzania obrazu, analizy dźwięku czy pracy z dużymi modelami językowymi. Wtedy wydajne GPU staje się nie tyle luksusem, ile narzędziem oszczędzającym dziesiątki godzin oczekiwania na wyniki.
Krótka odpowiedź: kiedy mocna karta graficzna jest potrzebna, a kiedy nie
Wyobraź sobie procesor (CPU) jako wybitnego uniwersalnego matematyka, który potrafi rozwiązać dowolne, nawet najbardziej skomplikowane równanie krok po kroku. Z kolei karta graficzna (GPU) przypomina ogromną halę produkcyjną, w której pracują tysiące mniej wykwalifikowanych pracowników. Jeśli zadanie wymaga wykonania milionów prostych, identycznych działań matematycznych w tym samym momencie – a tym właśnie jest mnożenie macierzy w sieciach neuronowych – hala produkcyjna poradzi sobie wielokrotnie szybciej niż pojedynczy, choćby najwybitniejszy matematyk. [3]
Warto wyraźnie rozdzielić proces nauki samych pojęć od trenowania produkcyjnych modeli. Na etapie poznawania algorytmów, czyszczenia danych i pisania pierwszych skryptów, obciążenie sprzętu jest minimalne. Zrozumienie, jak działa regresja czy walidacja krzyżowa, nie wymaga dedykowanego układu graficznego. Zależność między potrzebami a sprzętem można ująć w trzech typowych scenariuszach:
- Początkujący adepci ML: Praca na danych tabelarycznych w bibliotekach takich jak scikit-learn. Tutaj mocna karta graficzna jest zbędna – procesor oraz 16 GB pamięci RAM w zupełności wystarczą.
- Osoby budujące portfolio: Praca z umiarkowanymi sieciami neuronowymi, klasyfikacja obrazów, analiza tekstu. Przydaje się podstawowa karta z rdzeniami Tensor lub darmowe środowiska chmurowe.
- Praktycy i badacze Deep Learningu: Trenowanie modeli od zera, dostrajanie (fine-tuning) dużych architektów wizyjnych czy modeli językowych. W tym przypadku wydajne GPU z dużą ilością pamięci VRAM jest absolutnie niezbędne.
Krok 1. Określ, jaki typ machine learningu chcesz wykonywać
Klasyczne modele ML — zwykle wystarczy procesor
Klasyczne uczenie maszynowe opiera się w głównej mierze na danych ustruktyzowanych. Są to wszelkiej maści tabele przypominające arkusze kalkulacyjne: dane sprzedażowe, bazy klientów, wyceny nieruchomości czy pomiary z czujników. Do pracy z takimi zbiorami wykorzystuje się algorytmy takie jak regresja liniowa i logistyczna, drzewa decyzyjne, lasy losowe (Random Forests) czy algorytmy oparte na wzmacnianiu gradientowym (XGBoost, LightGBM, CatBoost).
Większość z tych algorytmów została zaprojektowana z myślą o wykonywaniu obliczeń na CPU. Operacje te świetnie skalują się z liczbą rdzeni procesora oraz szybkością pamięci RAM. Kupowanie drogiego GPU do nauki biblioteki scikit-learn nie ma uzasadnienia ekonomicznego. W tym obszarze znacznie częstszym wąskim gardłem okazuje się zbyt mała ilość pamięci operacyjnej komputera (RAM), która uniemożliwia wczytanie całego zbioru danych do pamięci, lub wolny dysk SSD spowalniający odczyt plików.
Deep Learning — GPU często radykalnie przyspiesza trening
Zapewne kojarzysz widowiskowe zastosowania AI: rozpoznawanie twarzy, generowanie obrazów na podstawie opisu, transkrypcję mowy czy automatyczne tłumaczenia. Wszystkie te rozwiązania wykorzystują uczenie głębokie (Deep Learning). Architektury takie jak konwolucyjne sieci neuronowe (CNN) czy transformatory opierają się na ciągłym przeliczaniu wag w milionach lub miliardach połączeń.
Trening głębokiej sieci neuronowej na procesorze może trwać tygodniami, podczas gdy ta sama operacja na nowoczesnej karcie graficznej zajmie kilkanaście minut. Różnica ta wynika ze specyfiki operacji na macierzach. Dedykowane układy graficzne posiadają tysiące małych rdzeni obliczeniowych stworzonych dokładnie do tego typu równoległej pracy. Jeśli więc Twoim celem jest tworzenie lub trenowanie sieci neuronowych w frameworkach PyTorch lub TensorFlow, posiadanie dostępu do GPU przestaje być opcją, a staje się koniecznością.
Gotowe modele i inferencja — potrzeby są inne niż przy treningu
Należy wyraźnie odróżnić proces trenowania modelu od procesu inferencji (czyli wykorzystywania już wyuczonego modelu do generowania predykcji). Trenowanie wymaga ogromnej mocy obliczeniowej, ponieważ model musi przejść przez dane tysiące razy, dostosowując swoje parametry. Inferencja to zaledwie pojedynczy przebieg danych przez gotowy układ równań.
Jeśli planujesz jedynie wdrożyć gotowy, wytrenowany model do aplikacji (np. wykrywanie obiektów na zdjęciu ze smartfona czy prosty bot tekstowy), wymagania sprzętowe są znacznie niższe. Wiele zaawansowanych modeli potrafi działać sprawnie na współczesnych procesorach lub zintegrowanych układach graficznych. Jednak praca lokalna z nowymi, dużymi modelami językowymi (LLM) czy generatorami obrazów (np. Stable Diffusion) wymaga sporych zasobów pamięci karty graficznej nawet wyłącznie do samej inferencji.
Krok
Krok 2. Sprawdź skalę danych i modelu, zanim spojrzysz na ceny kart
Ten sam typ zadania może mieć zupełnie inne wymagania sprzętowe zależnie od skali. Klasyfikator uczący się na kilku tysiącach zdjęć produktów można uruchomić nawet w darmowym środowisku chmurowym. Gdy zbiór rośnie do setek tysięcy obrazów, a model ma być trenowany wielokrotnie podczas eksperymentów, czas obliczeń szybko staje się realnym kosztem. To trochę jak różnica między gotowaniem obiadu dla dwóch osób a obsługą restauracji w porze lunchu: przepis pozostaje podobny, ale potrzebujesz innej kuchni.
Spójrz przede wszystkim na trzy rzeczy: rozmiar zbioru danych, liczbę parametrów modelu oraz liczbę planowanych prób. Jednorazowe uruchomienie treningu może trwać długo i jeszcze da się to zaakceptować. Problem zaczyna się wtedy, gdy chcesz zmienić architekturę, parametry uczenia, sposób przygotowania danych i porównać kilkanaście wariantów. Jeśli pojedynczy eksperyment na CPU trwa wiele godzin, nauka zamienia się w czekanie.
Przy GPU kluczowa jest nie tylko szybkość układu, lecz także pamięć VRAM. To ona przechowuje w trakcie pracy model, fragment danych oraz wyniki pośrednich obliczeń. Karta z małą pamięcią może być teoretycznie szybka, a mimo to nie uruchomić wybranego modelu przy sensownym rozmiarze partii danych. W praktyce komunikat o braku pamięci GPU potrafi pojawić się szybciej niż pierwszy wynik treningu. Dla prostych projektów wystarcza skromniejszy zapas VRAM, natomiast przy modelach językowych, generowaniu obrazów i fine-tuningu zapotrzebowanie rośnie bardzo szybko. [1]
Najrozsądniejsza decyzja nie polega więc na kupieniu najmocniejszej dostępnej karty, lecz na dopasowaniu sprzętu do najbliższego realnego projektu. Do nauki klasycznego ML wystarczy solidny procesor, odpowiednia ilość RAM i szybki dysk. Przy głębokim uczeniu dostęp do GPU — własnego albo chmurowego — daje swobodę eksperymentowania, ale dopiero skala danych i modelu pokazuje, jak mocnego sprzętu rzeczywiście potrzebujesz.
Krok 3. Wybierz środowisko obliczeń: CPU, własne GPU czy chmura
Przejście od teorii do praktyki wymaga podjęcia decyzji o miejscu wykonywania obliczeń. Sprzęt nie musi od razu stać na Twoim biurku. Współczesny ekosystem uczenia maszynowego daje dużą elastyczność w dopasowywaniu zasobów do bieżących potrzeb.
Obliczenia na lokalnym CPU
To rozwiązanie domyślne i zerokosztowe, jeśli posiadasz już sprawny komputer. Praca na procesorze eliminuje problemy związane z konfigurowaniem sterowników graficznych i bibliotek dedykowanych dla układów GPU. Dla małych projektów, czyszczenia danych oraz prototypowania modeli tabelarycznych lokalny procesor z 16–32 GB RAM zapewnia w zupełności wystarczającą płynność pracy.
Chmura i środowiska notebooków (Google Colab, Kaggle, dostawcy GPU)
Darmowe środowiska, takie jak Google Colab czy Kaggle Notebooks, oferują nieodpłatny dostęp do wydajnych kart graficznych z poziomu przeglądarki internetowej. To optymalne miejsce do stawiania pierwszych kroków w głębokim uczeniu bez ponoszenia nakładów finansowych. Dostępne są tam również płatne subskrypcje oraz usługi wynajmu mocy obliczeniowej na godziny (np. RunPod, Vast.ai, AWS czy GCP).
- Zalety chmury: brak kosztów zakupu sprzętu, natychmiastowy dostęp do najnowszych układów (np. NVIDIA A100/H100), wstępnie skonfigurowane środowiska programistyczne.
- Wady chmury: ograniczenia czasowe w darmowych wersjach (rozłączanie sesji), konieczność przesyłania dużych zbiorów danych przez internet, narastające koszty przy ciągłym użytkowaniu.
Własna, dedykowana karta GPU
Inwestycja we własny układ graficzny opłaca się osobom, które codziennie pracują z głębokimi sieciami neuronowymi, wykonują setki szybkich iteracji lub pracują na poufnych danych, których nie mogą przesyłać na zewnętrzne serwery. Własne GPU daje pełną kontrolę nad czasem obliczeń i brakiem ograniczeń czasowych sesji.
Krok 4. Jeśli kupujesz GPU, oceń je według właściwych parametrów
Dobór karty graficznej do gier komputerowych różni się od doboru sprzętu do zadań machine learningu. Wydajność w grach zależy od taktowania i klatek na sekundę, natomiast w ML kluczowe są inne elementy architektoniczne układu.
1. Pojemność pamięci VRAM (najważniejsze kryterium)
Brak wystarczającej ilości pamięci VRAM Uniemożliwia załadowanie modelu do karty. Przyjmuje się następujące progi użyteczności dla zadań uczenia głębokiego:
- 8 GB VRAM: absolutne minimum do nauki prostych sieci wizyjnych i małych modeli. Występuje ryzyko szybkiego wyczerpania pamięci.
- 12 GB – 16 GB VRAM: optymalny przedział dla entuzjastów i praktyków. Pozwala na sprawny dostrajanie (fine-tuning) umiarkowanych modeli wizyjnych oraz mniejszych modeli językowych (np. 7B/8B parametrów po kwantyzacji).
- 24 GB VRAM i więcej: standard pracy dla zaawansowanych projektów Deep Learningu, pracy z większymi modelami generatywnymi oraz obszernymi rozmiarami partii (batch size).
2. Ekosystem i wsparcie sterowników (NVIDIA vs reszta rynku)
Obecnie standardem branżowym w uczeniu maszynowym pozostaje architektura **NVIDIA CUDA**. Większość bibliotek (PyTorch, TensorFlow) oraz gotowych repozytoriów na platformie GitHub jest natywnie optymalizowana pod kątem układów tej firmy. Karty marki AMD (z frameworkiem ROCm) oraz układy Apple Silicon (MPS) nadrabiają zaległości i stają się coraz bardziej użyteczne, jednak dla osób początkujących NVIDIA oferuje najbardziej bezobsługowe środowisko bez konieczności ręcznej kompilacji bibliotek.
3. Dedykowane rdzenie do obliczeń sztucznej inteligencji (Tensor Cores)
Współczesne karty posiadają wyspecjalizowane jednostki przyspieszające obliczenia na macierzach. Rdzenie Tensor pozwalają na drastyczne przyspieszenie treningu i inferencji poprzez wykorzystanie niższej precyzji obliczeniowej (np. FP16, BF16 lub INT8) bez znaczącej utraty dokładności modelu.
4. Przepustowość pamięci (Memory Bandwidth)
Szerokość magistrali i przepustowość pamięci (wyrażana w GB/s) decydują o tym, jak szybko dane są przesyłane między rdzeniami obliczeniowymi a pamięcią VRAM. Wysoka przepustowość jest szczególnie istotna przy generowaniu tekstu przez modele językowe oraz przetwarzaniu dużych strumieni danych.
Lista kontrolna: procedura wyboru i weryfikacji sprzętu
Zanim podejmiesz ostateczną decyzję finansową lub zaczniesz kompletować zestaw komputerowy, przejdź przez poniższą procedurę sprawdzającą. Pozwoli Ci ona uniknąć wyboru niewłaściwych rozwiązań i przepłacenia za zasoby, których nie wykorzystasz.
- Przetestuj kod na danych próbnych (CPU): Uruchom pierwsze wersje skryptów na małym fragmencie danych lokalnie na procesorze. Upewnij się, że cała ścieżka przetwarzania danych działa poprawnie i nie generuje błędów składniowych.
- Uruchom pilotaż w darmowej chmurze: Przenieś kod do Google Colab lub Kaggle. Włącz darmowe akceleratory GPU i zmierz czas trwania jednej epoki treningu oraz maksymalne zużycie pamięci VRAM.
- Przelicz zapotrzebowanie na VRAM: Jeżeli podczas pilotażu zużycie pamięci zbliża się do limitu przydzielonego akceleratora, pomnóż planowany rozmiar partii danych (batch size) lub wielkość modelu przez współczynnik bezpiecznego zapasu (minimum 1,2–1,5).
- Porównaj koszt zakupu z kosztami wynajmu: Oblicz, ile godzin w miesiącu karta będzie pracować pod pełnym obciążeniem. Jeśli planujesz intensywne obliczenia jedynie sporadycznie, usługa wynajmu mocy na godziny w chmurze będzie znacznie tańsza niż zakup sprzętu na własność.
- Sprawdź kompatybilność fizyczną komputera: Jeśli wybierasz własne GPU, zmierz przestrzeń w obudowie, zweryfikuj moc zasilacza (z uwzględnieniem skoków poboru prądu) oraz wydajność systemu chłodzenia w obudowie.
Ostrzeżenia: czego unikać przy wyborze sprzętu do ML
Kompletowanie środowiska do uczenia maszynowego niesie ze sobą kilka pułapek technicznych i finansowych, które najczęściej dotykają osoby początkujące:
- Ignorowanie zapotrzebowania na prąd i chłodzenie: Karta graficzna obciążona treningiem sieci neuronowej pobiera maksymalną moc przez wiele godzin. Słabe chłodzenie doprowadzi do automatycznego obniżania taktowania zegarów (thermal throttlingu), a za słaby zasilacz do wyłączania komputera w połowie procesu uczenia.
- Zakup karty z szybkim rdzeniem, ale małą ilością VRAM: W grach komputerowych mniejszy bufor pamięci może być kompensowany wydajną obróbką klatek, lecz w uczeniu maszynowym przepełnienie VRAM natychmiast przerywa działanie programu błędem braku pamięci (CUDA Out of Memory).
- Niekontrolowane koszty w chmurze komercyjnej: Zostawienie uruchomionej, płatnej instancji z wydajnym GPU u dostawców chmurowych bez ustawionych limitów budżetowych i alertów cenowych może skutkować bardzo wysokimi rachunkami za czas, w którym serwer bezczynnie czekał na instrukcje.
- Pomijanie wydajności pamięci RAM i dysku SSD: Najszybsza karta graficzna będzie bezczynna, jeśli procesor nie nadąży z dostarczaniem i przygotowywaniem danych. Wąskim gardłem bardzo często staje się wolny dysk HDD lub zbyt mała ilość pamięci systemowej RAM.
Praktyczne wdrożenie: jak zacząć krok po kroku
Najrozsądniejszym podejściem do budowania środowiska obliczeniowego jest stopniowe skalowanie zasobów wraz ze wzrostem skomplikowania realizowanych projektów:
Rozpocznij od pracy na własnym procesorze i wykorzystaj darmowe środowiska chmurowe do przetestowania pierwszych modeli uczenia głębokiego. Gdy natrafisz na ograniczenia darmowych limitów czasowych, przejdź na instancje rozliczane za sekundy u dostawców chmurowych. Dop
iero gdy regularnie wykorzystujesz GPU, znasz rzeczywiste zużycie VRAM i wiesz, że chmura ogranicza tempo pracy, zakup własnej karty zaczyna mieć ekonomiczny sens. Taki rozwój przypomina wymianę narzędzi w warsztacie: na początku wystarczy podstawowy zestaw, a specjalistyczny sprzęt kupuje się wtedy, gdy jego brak naprawdę spowalnia pracę.
Nie kupuj karty wyłącznie „na przyszłość”, jeśli nie masz jeszcze konkretnego zastosowania. Rynek sprzętu zmienia się szybko, natomiast dobrze działający projekt i poprawnie przygotowany pipeline danych zachowują wartość niezależnie od tego, gdzie wykonujesz obliczenia. Najpierw sprawdź, czy ograniczeniem jest faktycznie GPU, a nie wolne ładowanie danych, zbyt duży model albo błędnie ustawiony batch size.
Kiedy mocna karta graficzna nie rozwiąże problemu
GPU przyspiesza przede wszystkim obliczenia równoległe, lecz nie naprawia wszystkich elementów procesu uczenia maszynowego. Jeśli przygotowanie danych trwa dłużej niż trening, nowa karta może przez większość czasu czekać bezczynnie. Podobnie będzie wtedy, gdy model jest źle dobrany do zadania lub eksperymenty nie są powtarzalne. [2]
Przykładowo model przewidujący rezygnację klientów na danych tabelarycznych często da się skutecznie zbudować na CPU. Zakup bardzo wydajnego akceleratora nie zastąpi sensownego podziału danych na zbiory treningowe i walidacyjne, kontroli wycieku danych ani właściwego doboru metryk. Moc obliczeniowa jest mnożnikiem dobrego procesu, nie jego zamiennikiem.
Krótka decyzja zakupowa
Jeżeli uczysz się podstaw, analizujesz dane tabelaryczne albo uruchamiasz gotowe modele sporadycznie, zacznij od CPU i darmowych notebooków. Gdy trenujesz sieci wizyjne, pracujesz z audio lub testujesz modele generatywne kilka razy w tygodniu, korzystanie z GPU w chmurze pozwoli sprawdzić faktyczne potrzeby bez wiązania budżetu ze sprzętem.
Własna mocna karta graficzna ma największy sens przy regularnej pracy z deep learningiem, dużej liczbie eksperymentów oraz wymaganiu pracy lokalnej. Przy wyborze najpierw patrz na VRAM i zgodność z używanym ekosystemem, a dopiero później na marketingową wydajność. Dobrze dopasowane GPU skraca czas oczekiwania, ale najlepszą inwestycją pozostaje sprzęt proporcjonalny do projektu — ani za słaby, ani kupiony na wyrost.
Najważniejsze punkty
- Do nauki klasycznego machine learningu, pracy z danymi tabelarycznymi i biblioteką scikit-learn zwykle wystarczy procesor, odpowiednia ilość RAM oraz szybki dysk SSD.
- GPU najbardziej przydaje się podczas trenowania głębokich sieci neuronowych, zwłaszcza modeli wizyjnych, dźwiękowych i językowych.
- Przy wyborze karty graficznej należy zwrócić uwagę nie tylko na jej szybkość, lecz także na ilość pamięci VRAM.
- Zamiast kupować własne GPU można korzystać z darmowych lub płatnych środowisk chmurowych, takich jak Google Colab, Kaggle czy usługi wynajmu mocy obliczeniowej.
- Najlepszy sprzęt zależy od skali danych, wielkości modelu i liczby planowanych eksperymentów, a nie wyłącznie od rodzaju zadania.
Pytania od czytelników
Czy laptop bez dedykowanej karty graficznej wystarczy do rozpoczęcia nauki ML?
Czy do każdego projektu z obrazami potrzebuję mocnego GPU?
Co jest ważniejsze w karcie do ML: szybkość czy pamięć VRAM?
Czy inferencja gotowego modelu wymaga takiego samego sprzętu jak trening?